本文讲清 Token 如何切分和计数,帮助你准确估算大模型的上下文占用和调用成本,并理解缓存能省下哪些重复计算和费用。
1. Token 是什么:模型读到的是编号
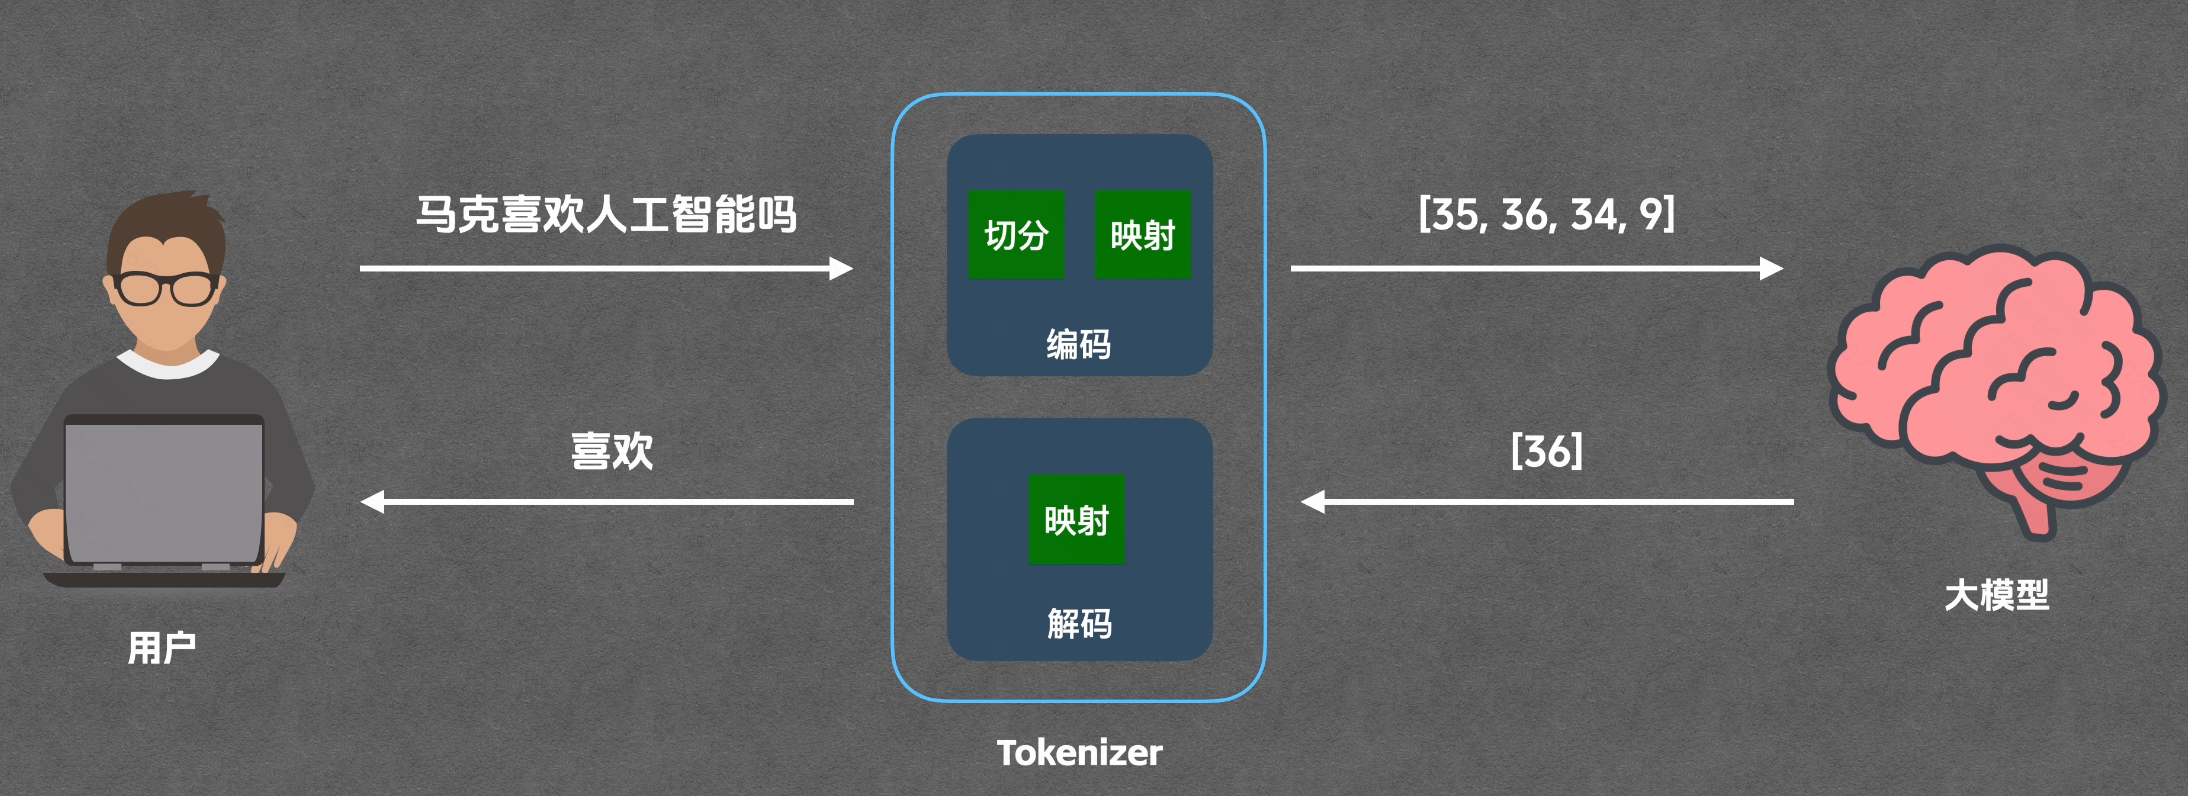
用户输入的是文字,模型内部处理的是数字(token id)。Tokenizer 就是这中间的翻译层——把文本变成 id 序列,也把 id 序列还原成文本。
前端类比:
就像源代码里写的是变量名字符串,编译后变成内存地址或寄存器编号——人能读懂名字,机器只认编号。模型也一样,不管输入的是中文还是英文,进去的都是一串整数。
成本单位
API 账单按 token 计。同样的意思,token 越少越便宜,但不能为了省钱让意思变模糊。
上下文单位
模型窗口(context window)装的是 token,不是字符。"128K 上下文"指的是 128,000 个 token。
预测单位
模型每一步预测下一个 token,再逐步生成完整回答。这就是为什么叫"自回归生成"。
中英文 Token 密度参考
| 文本类型 | 经验估算 | GPT-4o / o200k_base 实测 |
|---|---|---|
| 英文 | 常见英文约 3–4 个字符 / token | hello world:2 tokens |
| 中文 | 受词表和具体内容影响,不能按固定汉字数折算 | 你好世界:2 tokens |
| 数字 / 代码 | 数字可能按多位一组切分,代码还受空格、标点影响 | 12345:2 tokens |
经验比例只适合粗估;右列使用本文的目标编码实测,不代表其他模型的切分结果。
2. Tokenizer 的两步:切分和查表
你可以把 Tokenizer 理解成一本"特殊的字典"。这本字典里存着几万到几十万个"片段"(有的是完整单词,有的是半个单词,有的是单个字符),每个片段对应一个编号。
编码时,Tokenizer 先按规则把文本拆成这本字典里有的片段,再查出每个片段的编号。解码时,它把编号反查回片段并拼起来。
输入文本: 人工智能没有人工
| 片段 | Token ID(o200k_base) |
|---|---|
| 人工 | 47243 |
| 智能 | 60319 |
| 没有 | 23714 |
| 人工 | 47243 |
注意:同一段文字放到不同模型里,token 数可能不同。模型使用的词表和切分规则可能不同,也有多个模型复用同一种编码的情况。本文的实测统一使用 GPT-4o 对应的 o200k_base,方便复现和比较。
训练阶段(一次性)
从大规模语料里"学"出这本字典和切分规则。这件事在模型发布前就做完了,和你用模型没关系。
使用阶段(每次请求)
你发的每一条消息,都用这本固定的字典做切分。字典不会因为你的输入而改变。
特殊 Token:不是你写的,但它们存在
很多模型的词表里还有专门的"系统 token",比如
<|im_start|>、<|endoftext|>、<|tool_call|>。它们用来标记对话的开始、结束、角色切换等结构信息。API 帮你处理了这些,但它们是占 token 的,也是为什么你的 system prompt 会比你写的字多几个 token 的原因。
3. BPE:先拆碎,再反复合并
BPE(Byte Pair Encoding,字节对编码)是最常见的词表训练方法。它的思路特别直接:高频出现的字符组合,就合并成一个新词;没有人用的组合,就保持碎片状态。
BPE 有点像给一门语言建"自动补全词典":先从单个字符开始,不断把那些总是一起出现的字符对合并成一个条目,最终词典里既有单字,也有常见词,甚至有长短语。
下面演示的是词表训练过程
下面的 Step 0–6 描述的是 tokenizer 被训练时发生的事,只做一次。你平时调 API 时,tokenizer 已经训练好了,直接用词表切分,不会重新学习。
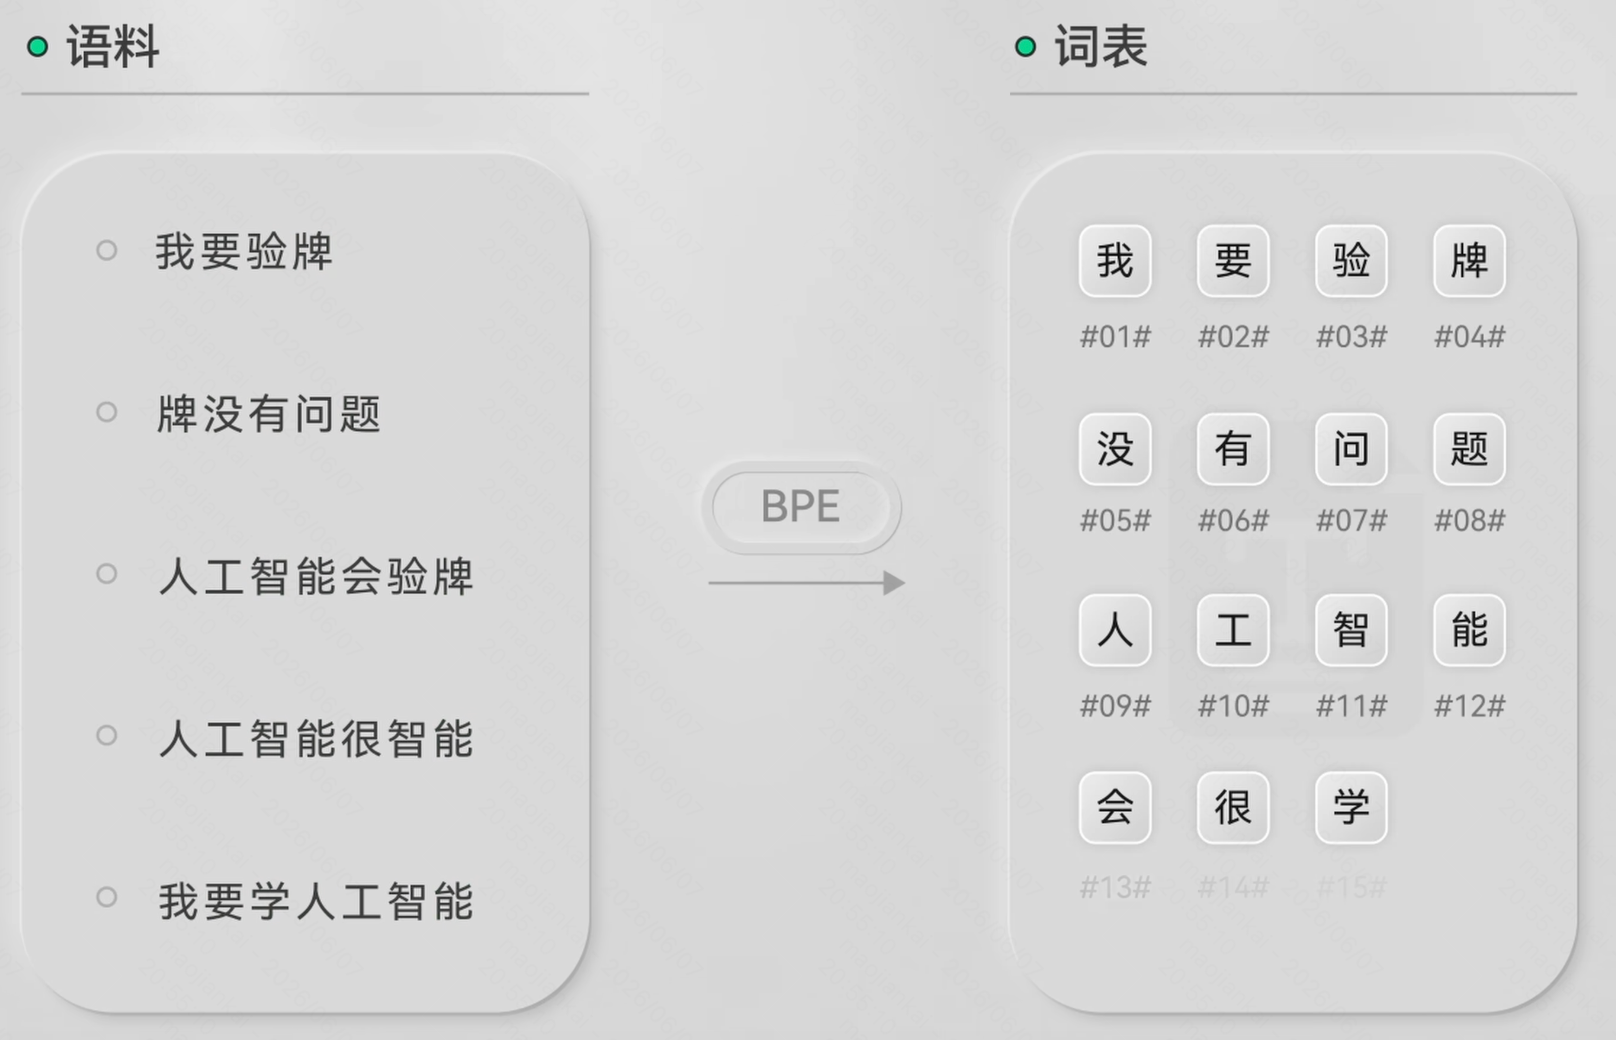
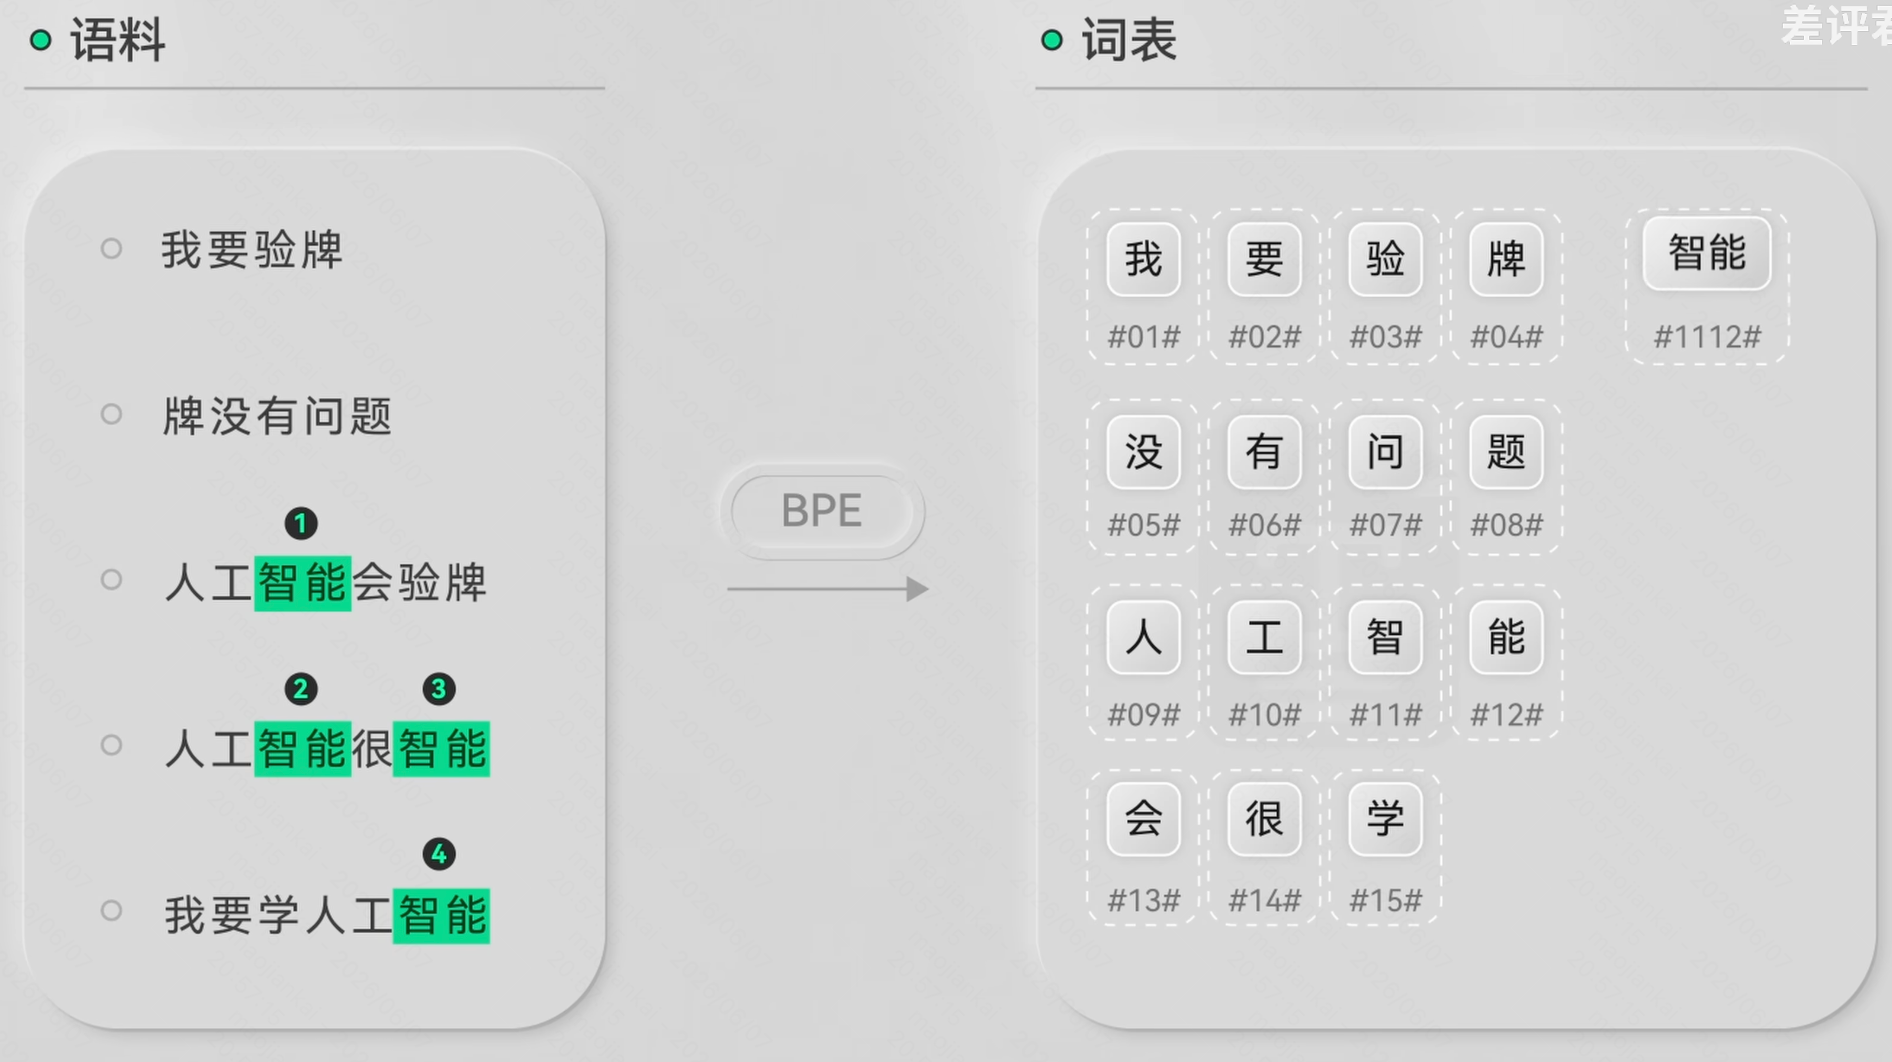
为了看清合并过程,配图使用按汉字拆分的简化词表。图中的片段和编号用于教学示意,不代表 GPT-4o 的实际编码。
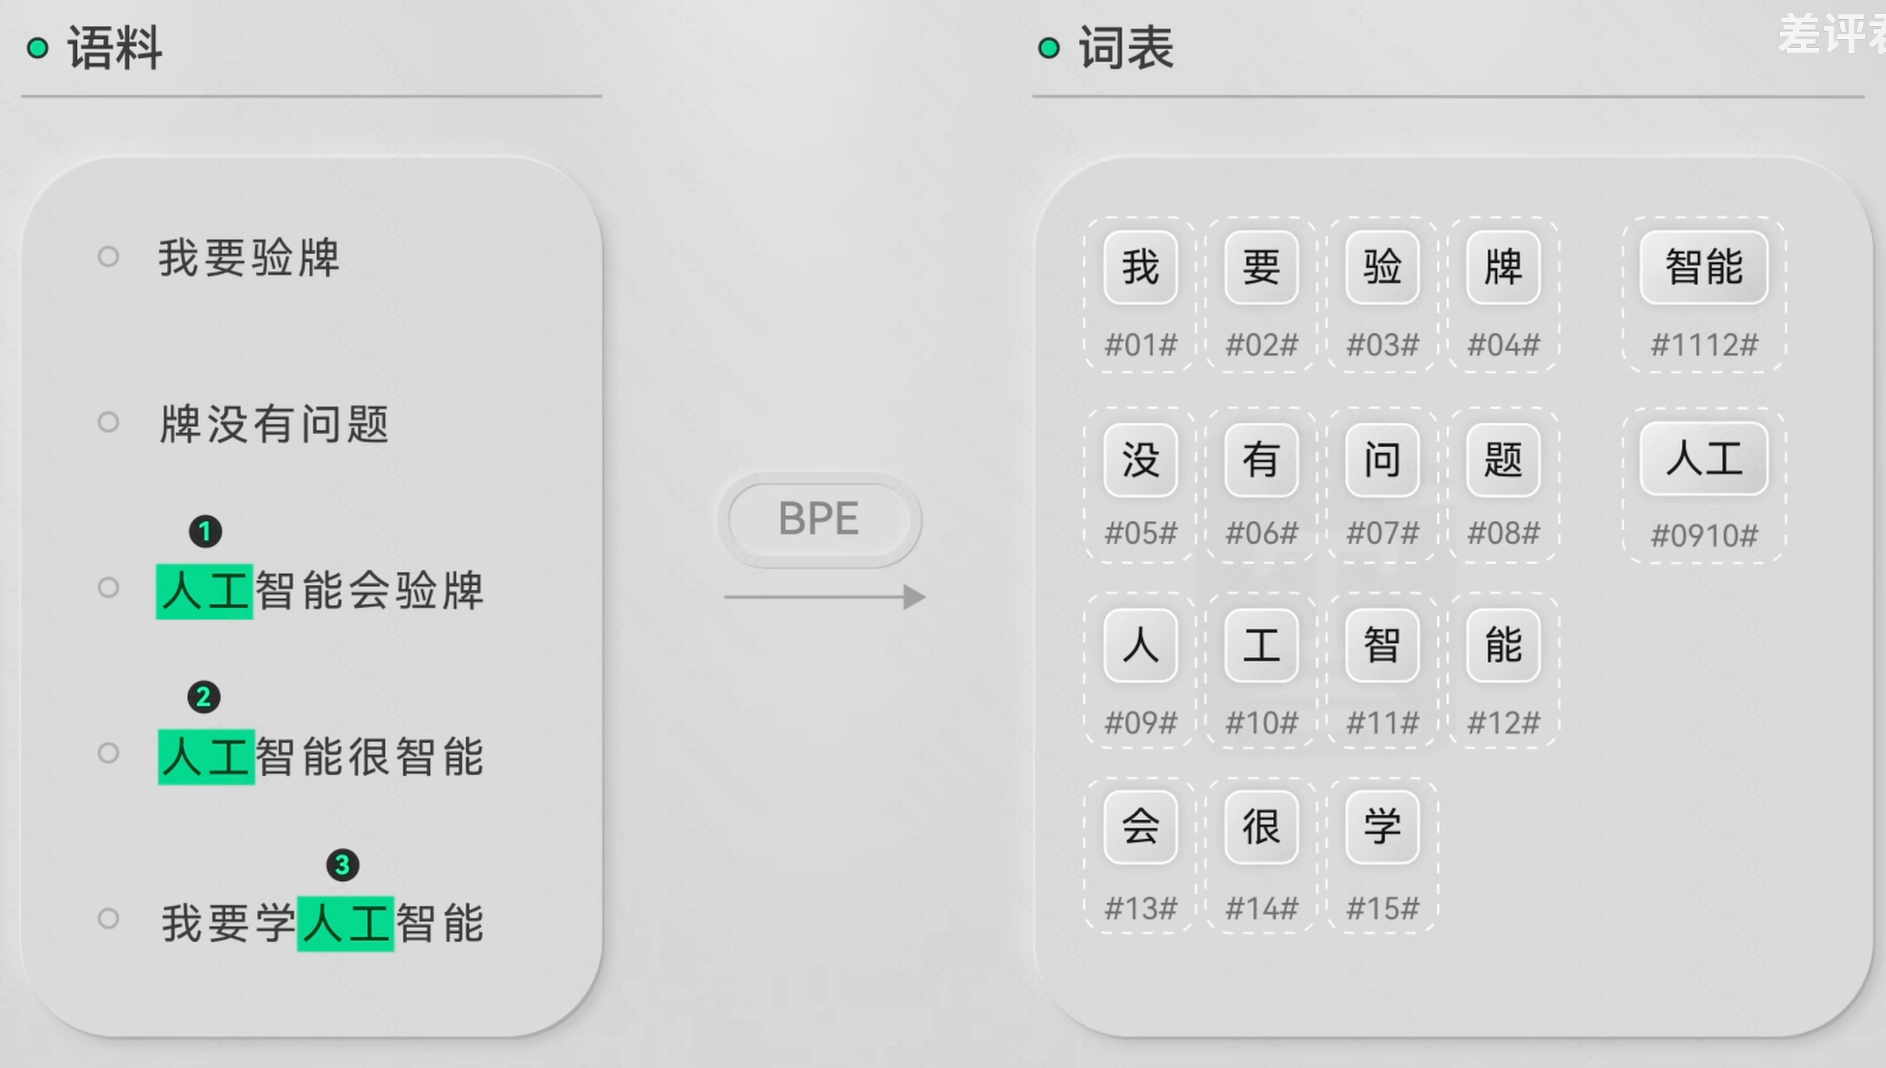
Step 0:准备语料
假设训练语料里反复出现这些句子:
- 我要验牌
- 牌没有问题
- 人工智能会验牌
- 人工智能很智能
- 我要学人工智能
Step 1:从最小单位开始
先把所有文本拆到最细粒度。这里先按汉字拆开,方便观察。字节级 BPE 会从字节出发,常见汉字在 UTF-8 中通常占 3 个字节;不同 tokenizer 的预处理和初始单位也可能不同。
Step 2:数一数哪两个相邻字符最常出现
遍历整个语料,统计相邻对的出现次数。
| 相邻片段 | 次数 |
|---|---|
| 智 + 能 | 4 |
| 人 + 工 | 3 |
| 验 + 牌 | 2 |
| 我 + 要 | 2 |
Step 3:合并最高频的对
"智 + 能"最高频,把它合并成一个新 token"智能",加入词表。语料里所有的"智能"都换成这个新 token。
智 + 能 → 智能
Step 4:重新统计,再合并
语料更新后,重新统计。下一轮最高频的可能是"人 + 工"。
人 + 工 → 人工
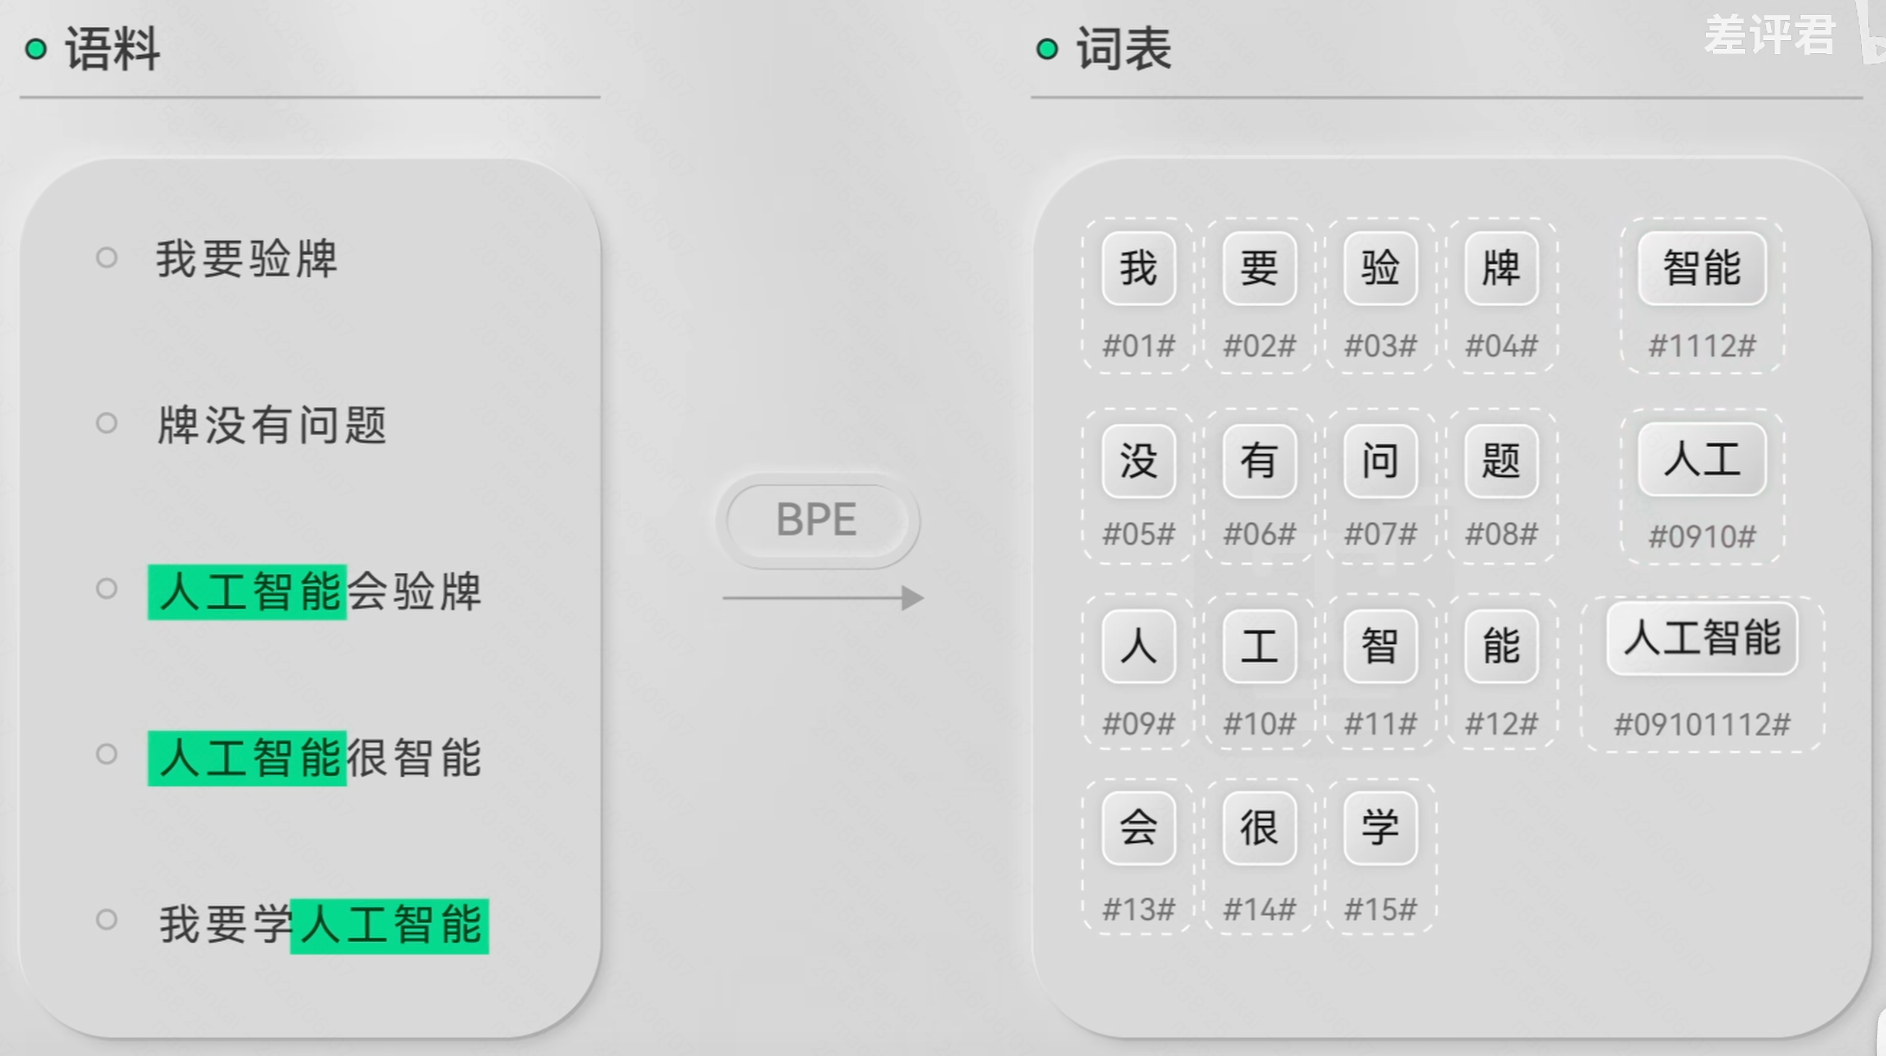
Step 5:短语继续变长
现在语料里有"人工"和"智能"两个 token 紧挨着出现,如果频次还是很高,它们会被合并成"人工智能"。
人工 + 智能 → 人工智能
Step 6:达到词表大小后停止
达到预设的词表规模或其他停止条件后,训练结束,词表固定。以后切分新文本,就按这张表和已有的合并规则来。不同编码的词表规模不同,不能把这个教学词表直接套到真实模型上。
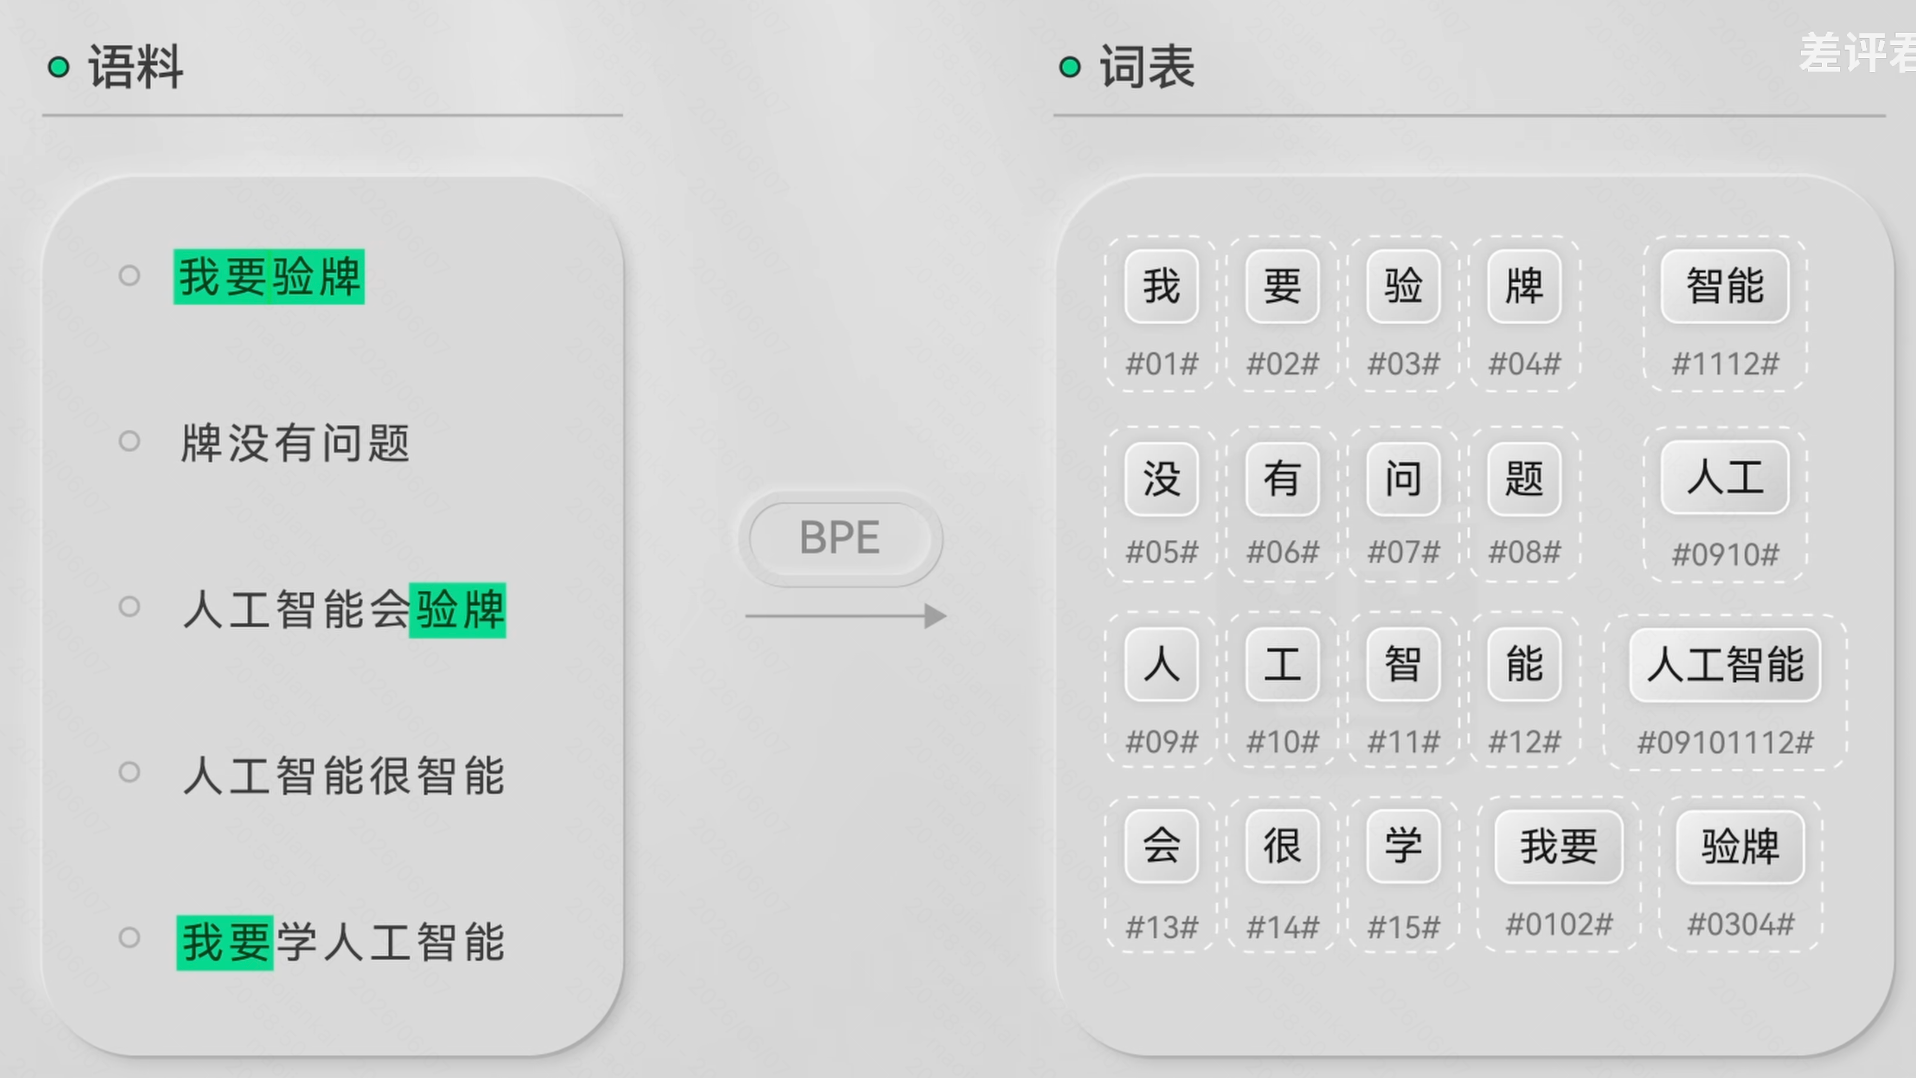
BPE 的本质:
高频组合有机会合并成较长的 token;词表里缺少的表达则会被拆成更小的片段。在上面的教学词表里,“人工智能”最终合并成了一块;实际用
o200k_base编码时,它仍是人工、智能两个 token。
不同模型,不同字典
BPE 只是最常见的方案之一。WordPiece、Unigram LM 也有人用,但核心思路相近:用有限的词表覆盖海量文本。同一段文字在 GPT-4 和 Claude 里 token 数可能不同,在 Qwen 和 DeepSeek 里又不同。统计成本时,必须用目标模型对应的 tokenizer,不能拿 GPT 的数字算 Qwen 的账单。
4. 文言文真的更省 Token 吗?
现在我们有了 tokenizer 的知识,可以来拆一拆。 同样一段意思,白话和文言文到底会被切成多少块?
下面使用 OpenAI tiktoken 的 o200k_base 编码实测。这些数量只统计示例文本本身,不包含 API 消息封装、工具定义等额外输入。
白话文
请你帮我把这段代码翻译成英文注释,并解释每一行的作用。
22 tokens(GPT-4o / o200k_base)
请 | 你 | 帮 | 我 | 把 | 这 | 段 | 代码 | 翻 | 译 | 成 | 英文 | 注 | 释 | ,并 | 解释 | 每 | 一 | 行 | 的 | 作用 | 。文言文
译此代码为英注,释每行之用。
13 tokens(GPT-4o / o200k_base)
译 | 此 | 代码 | 为 | 英 | 注 | , | 释 | 每 | 行 | 之 | 用 | 。这个例子说明了什么?
在这组输入和编码下,文言少了 9 个 token,约 41%。但注意:文言里的“英注”被拆成了“英”和“注”,白话里的“英文”是一个完整 token。“翻译”“注释”同样没有按我们直觉中的词边界保留。
结论: 这组文言表达更短,实测 token 也更少;换一组句子或换一个模型,结果可能不同。冷僻表达可能被拆得更碎,是否省 token 要看具体词表。
字数少 ≠ token 数少
token 按词表和编码规则切分,不能直接按字数折算。本文中“人工智能”和“英注”都是 2 个 token,但前者有 4 个汉字,后者只有 2 个。
省了 token,可能费了模型
表达过于晦涩,模型理解不准,来回追问或纠错,消耗的 token 可能比省下的还多。
判断方法只有一种
用目标模型的 tokenizer 实测。字数、汉字数都只是参考,不是准数。
白话
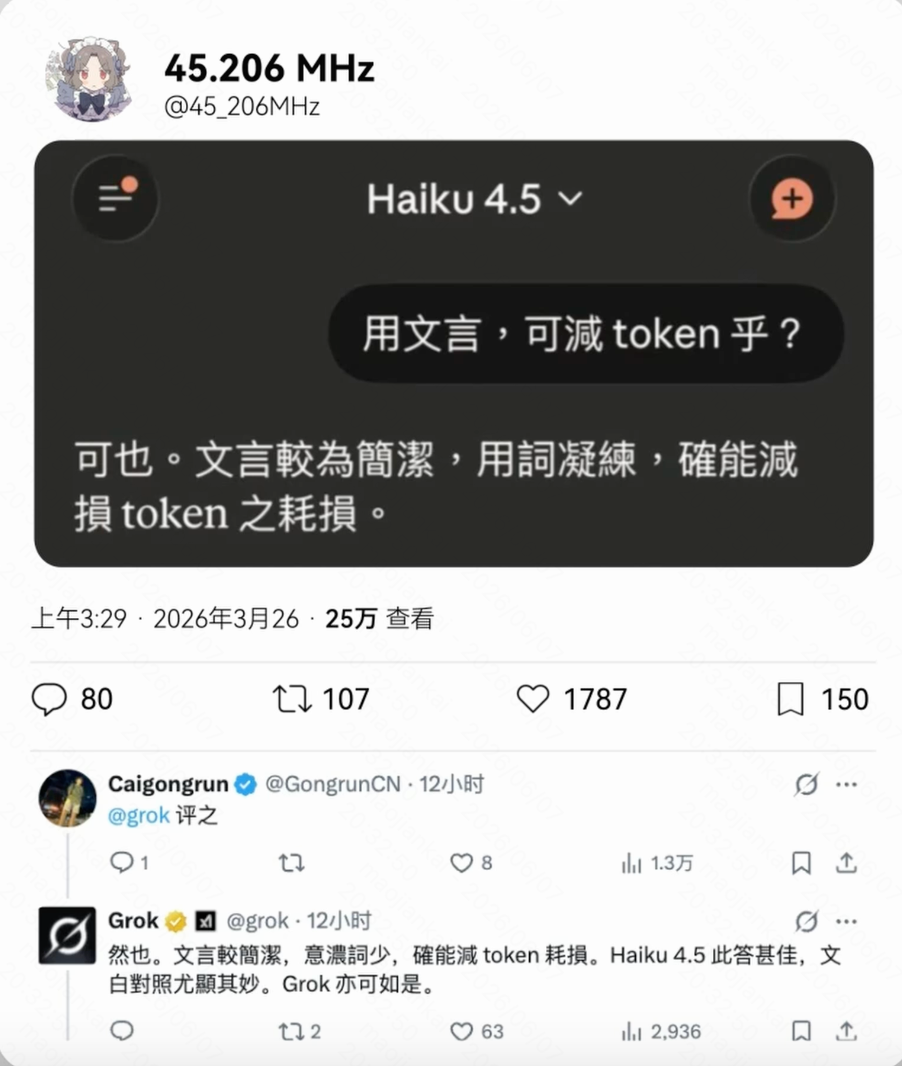
用文言,可以减少 token 吗?
语义清晰,略长。
文言
文言可减 token 乎?
这句字数更少,但能节省多少 token 还需要实测。用 o200k_base 编码,上面两句话分别是 9 和 8 个 token;空格也会影响切分。
结论
用 tokenizer 实测
只看字数会误判。两句话丢进 tiktoken 数一数才算数。
5. 四个反直觉案例
① strawberry 不一定按单词切分
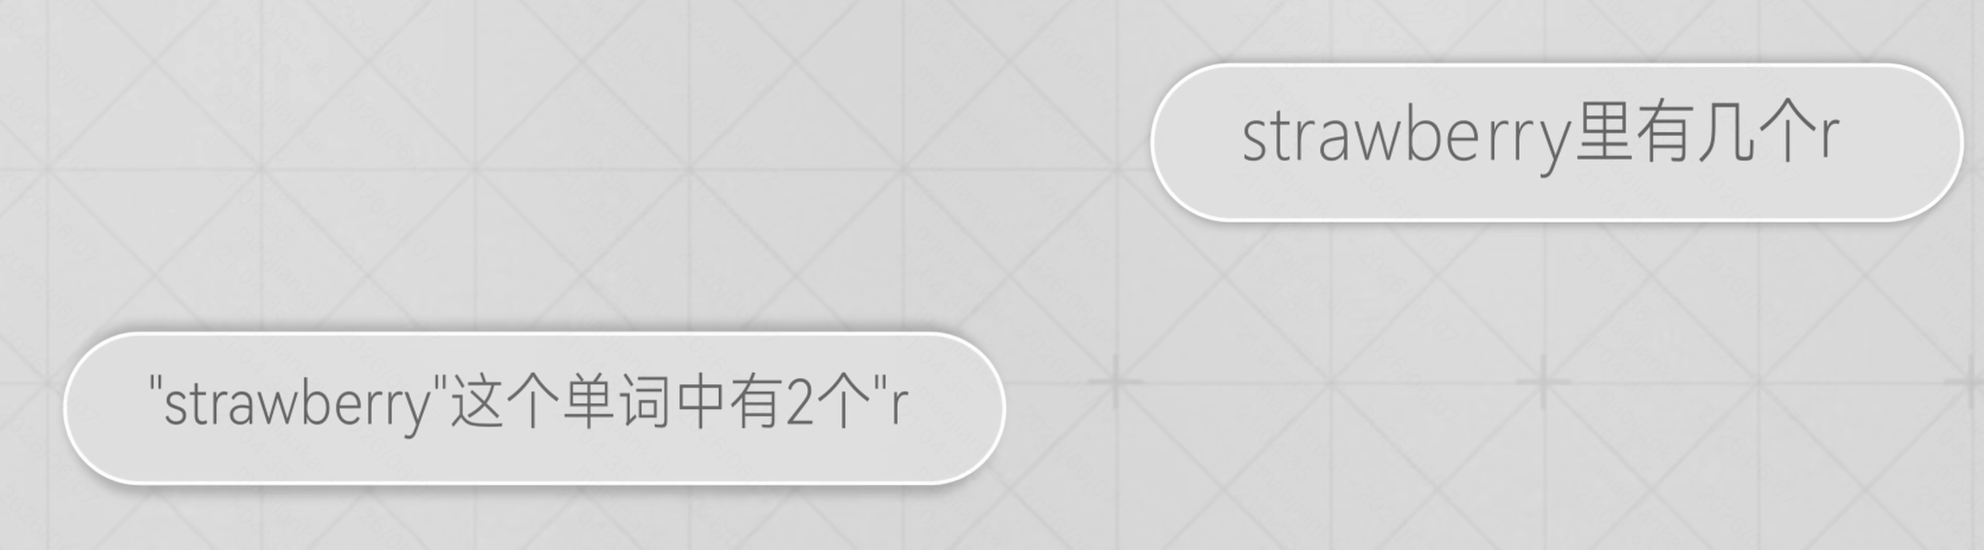
st | raw | berry → 3 tokens(o200k_base)
strawberry 有 10 个英文字母。在 o200k_base 下,它被切成 st、raw、berry;换成 cl100k_base,则是 str、aw、berry。两者都是 3 个 token,边界却不同。
这种表示方式有助于理解数单词中字母为什么可能出错:模型的基本输入单位和字符边界不重合,数出 3 个 r 还需要进一步处理。切分只是影响因素之一,不能仅凭 token 边界断定某个模型一定会答错。
② 9.11 和 9.9,谁更大?
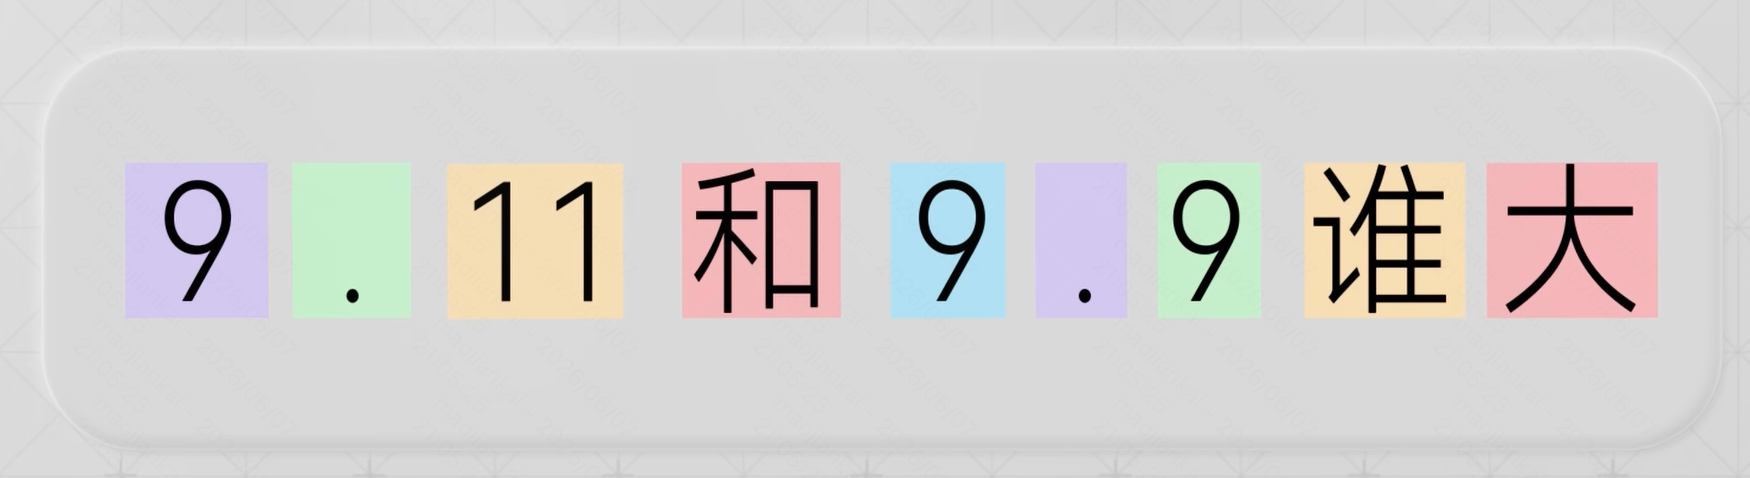
这是一个常见的模型测试题。按小数比较,答案是 9.9 更大。用 o200k_base 编码,9.11 被切成 9、.、11,9.9 被切成 9、.、9。
数字片段的表示可能影响推理,但答错不能完全归因于 tokenizer。训练数据、题目语境和模型能力都会产生影响。工程上需要精确计算时,可以让程序或计算工具完成运算,再由模型解释结果。
③ 早期中文:同样内容,token 消耗可能比英文高
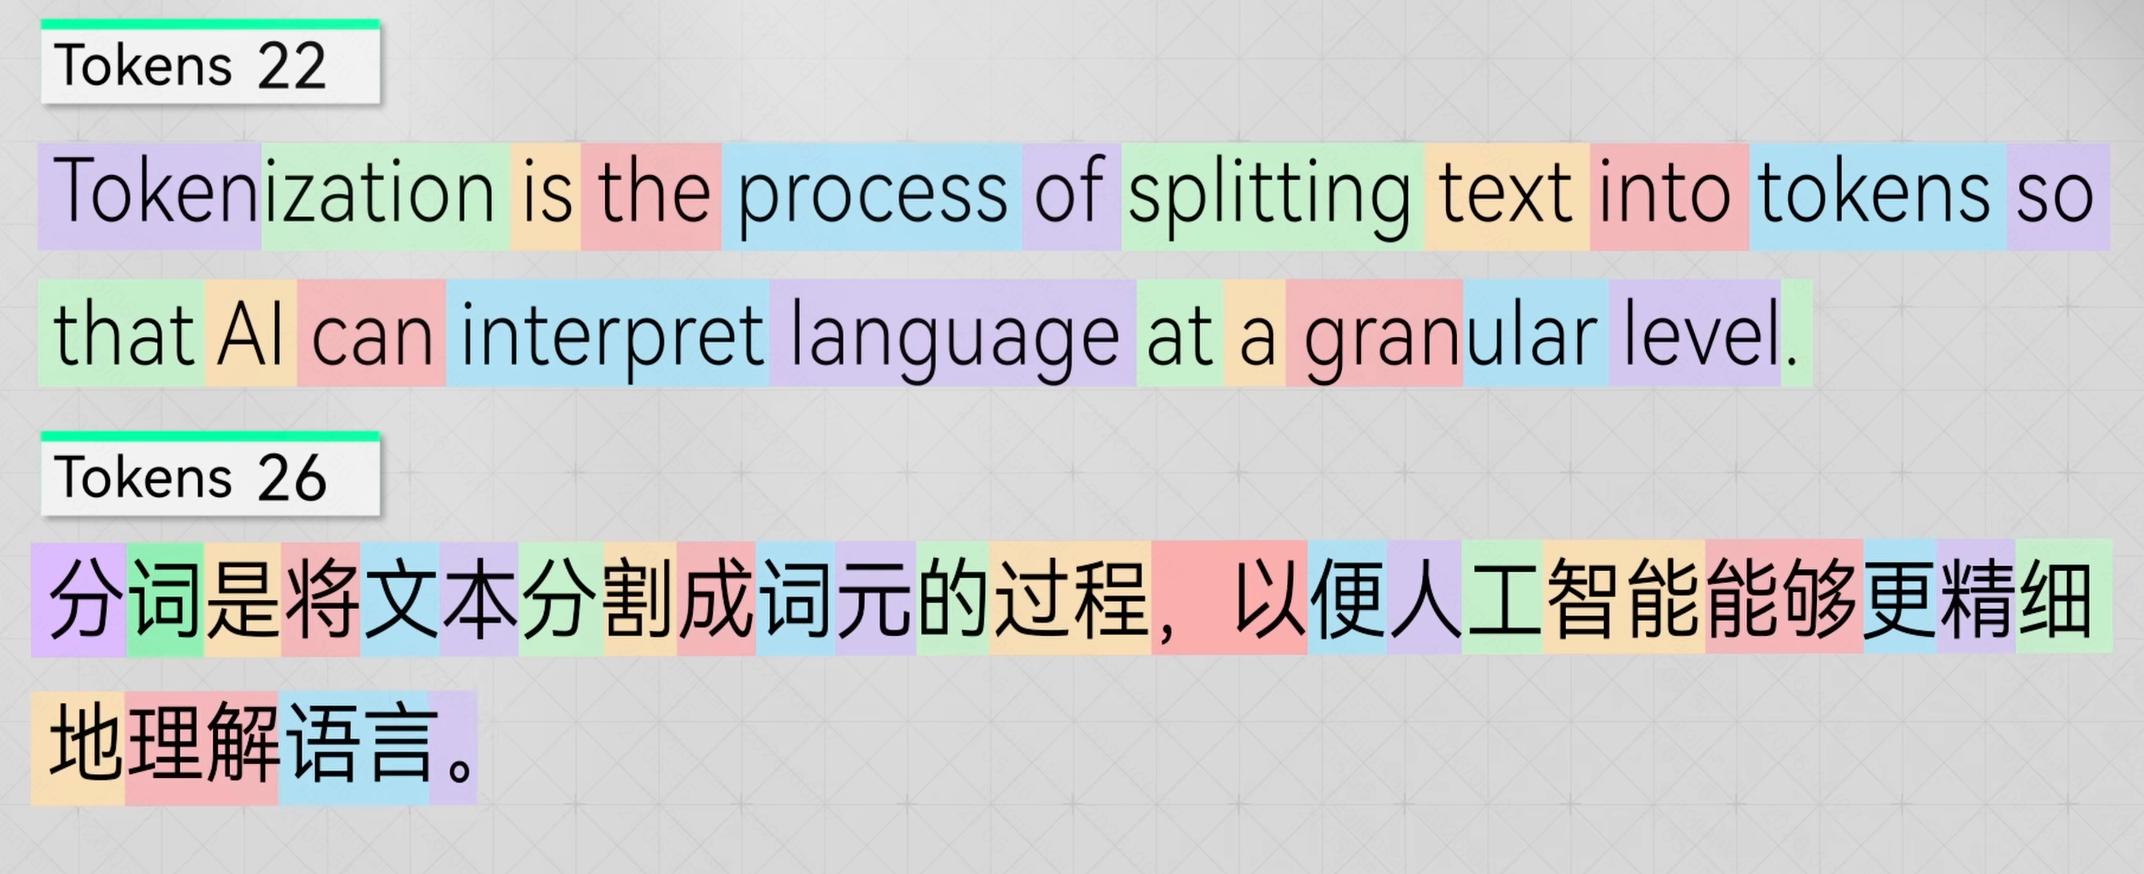
早期很多 tokenizer 对英文更友好:英文里常见词、词根、空格加单词会被合并成较长 token;中文常常被拆得更碎,同样长度的信息会消耗更多 token。结果就是:同样一段意思,中文输入可能更快占满上下文,也可能更贵。
这几年多语言 tokenizer 已经改善很多,中文不再总是吃亏。工程上仍然要按目标模型实测,别用"中文字符少"或"英文字符多"来猜成本。
④ MiniMax / 马嘉祺:故障 token 会让名字生成出错
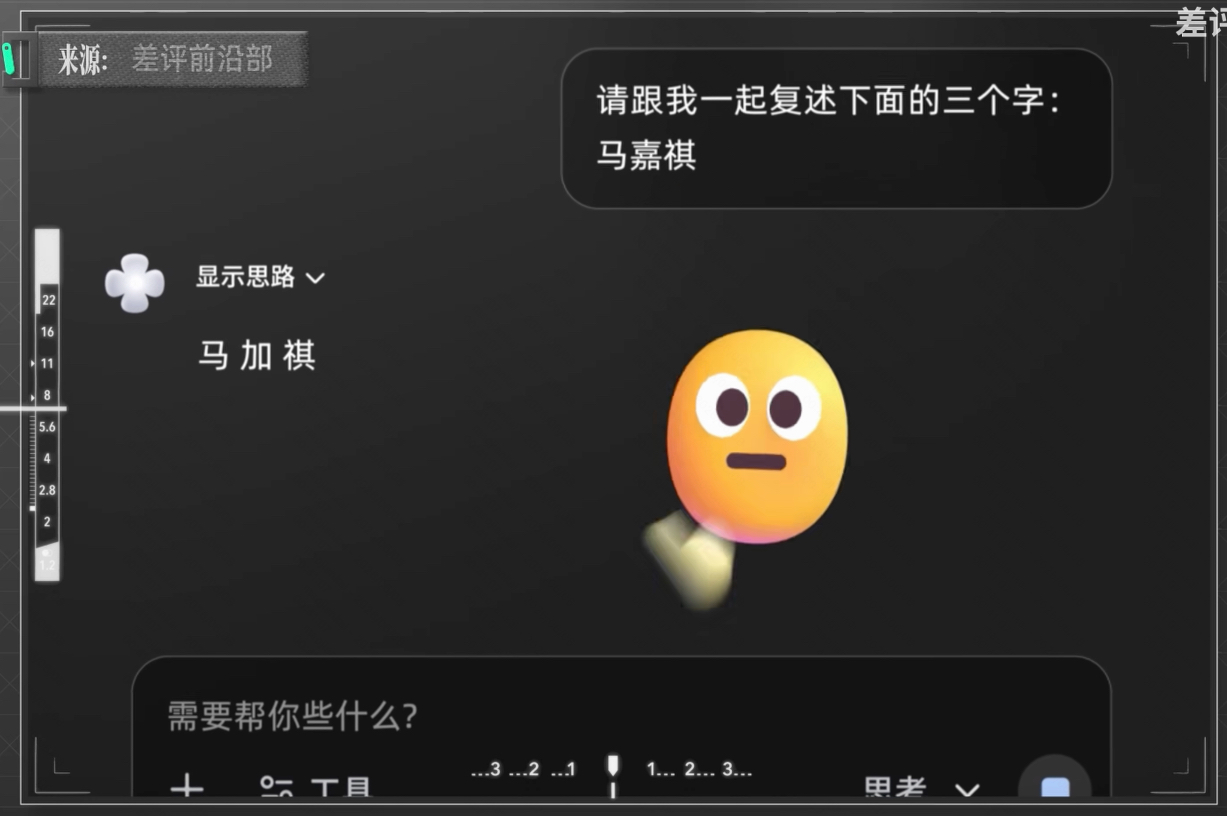
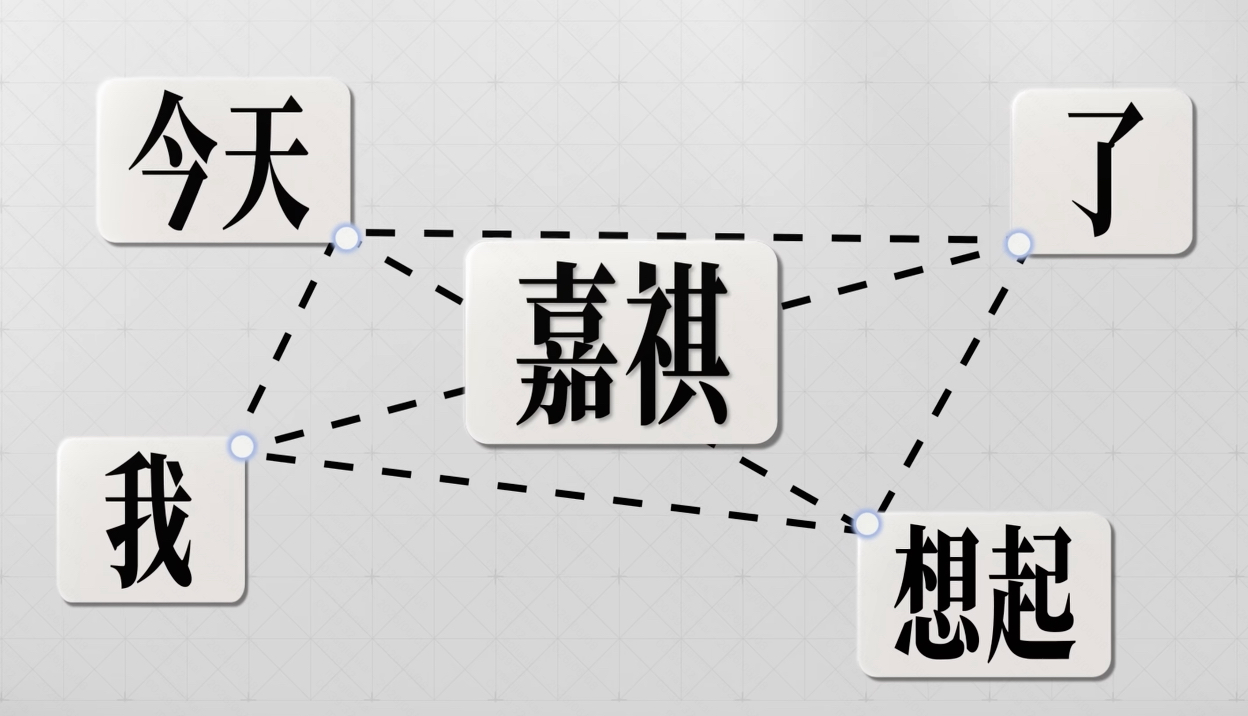
原文引用了 xinfinite.net 对 MiniMax「马嘉祺」现象的整理,并保留了当时的截图。这里把它作为历史案例,截图不能代表当前版本的表现。
一种可能的解释是:片段进入了词表,但在模型训练数据中的覆盖不足,模型没有充分学会它的使用方式。就像字典里查得到一个词,却很少见过它用在句子里。仅凭截图,还不能确认这个具体案例的训练成因。
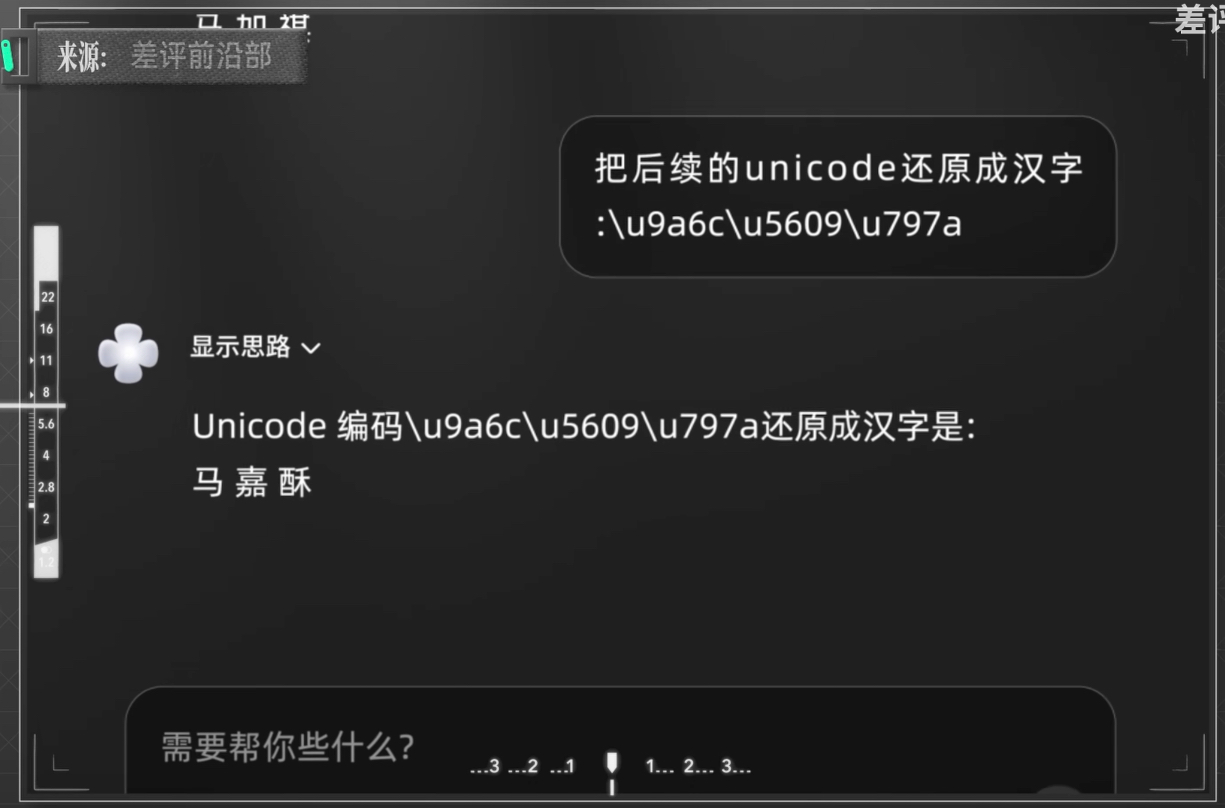
一个 token 进了词表,不代表模型真正懂它
词表覆盖和模型对片段的学习程度是两件事。排查异常输出时,可以检查切分结果、训练覆盖和上下文,但需要证据才能判断具体原因。
这四个例子的共同规律:
token 是词表里的"片段",和我们直觉里的"词"、字符数都不完全对得上。遇到需要精确计算的场景(成本预估、上下文管理),一定要用 tokenizer 工具实测,别靠感觉估。
6. 项目里怎么统计 Token
估算适合预算阶段,精算要调用目标模型对应的 tokenizer。
方法一:估算法
英文按字符数 ÷ 4 等经验比例粗估,适合早期预算。中文、代码、数字混排的差异更大,最好用目标场景的样本校准比例,不要把估算值当作账单。
方法二:精算法
用目标模型 tokenizer 编码文本,直接数 token ids 的长度。这样能准确统计这段文本,但完整 API 请求还可能包含消息结构、工具定义和其他输入。
方法三:落库法
每次请求结束后,从 API 响应里读取 usage.prompt_tokens 和 completion_tokens,存进数据库,作为计费和优化依据。
前端/Node.js 精算示例(以 GPT-4o 为例)
// npm install tiktoken
import { encoding_for_model } from 'tiktoken';

const enc = encoding_for_model('gpt-4o'); // o200k_base

try {
  const samples = [
    '你好,世界',
    'Hello, world',
    '请你帮我把这段代码翻译成英文注释,并解释每一行的作用。',
    '译此代码为英注,释每行之用。',
  ];

  for (const text of samples) {
    console.log(text, enc.encode(text).length);
  }
  // 以上四段文本依次是 3、3、22、13 tokens。
} finally {
  enc.free();
}
真正上线时要把这些都算进去
输入侧要把这些内容一起统计:
- system / developer 提示词
- 用户当前问题
- 历史消息(多轮对话)
- 检索出来的文档(RAG)
- 工具定义(tools)
- 工具调用结果(tool results)
上下文规划时还要预留输出空间。预留的最大输出数量不等于实际消耗;请求结束后,以 API 返回的真实 usage 和对应计费规则为准。
// 从 API 响应里读真实消耗
// response 为已有的 Chat Completions 请求结果。

const { prompt_tokens, completion_tokens, total_tokens } =
  response.usage;

// 如果有 prompt cache,还会有:
// prompt_tokens_details.cached_tokens
常见的漏算点:
工具定义(function schema)有时候会吃掉几百个 token;多轮对话的历史消息如果不截断,几轮之后就会撑满上下文窗口;RAG 场景下召回的文档片段往往是最大的 token 消耗项。
前面说的是 token 从哪里来、怎么数。
接下来说的是:这些 token 被送给模型之后,真的每一个都会被模型拿来运算吗?
答案:不一定。
7. Token 与缓存:算过的还要重算吗?
想象一个场景:你的 AI 助手每次收到用户消息,都会在最前面拼上同一段 system prompt——"你是一个专业的客服助手,以下是产品说明文档……"。这段话今天发是这样,昨天发也是这样。
这里说的“算”,指 token 进入模型后的计算。Tokenizer 编码和模型推理是不同步骤;本地统计工具会在客户端编码,调用模型 API 时服务端也会处理输入。缓存讨论的是模型处理结果的复用,不会把输入文本改成更少的 token。
它真的需要每次都重新处理一遍吗? 不需要。这就是 Prompt Cache 存在的原因——把固定不变的前缀处理结果缓存下来,下次请求直接复用。
同理,模型在生成回答时,每生成一个新 token,都不需要把前面所有 token 重新算一遍——把算过的结果存起来追加即可。这是 KV Cache 做的事。
两种缓存解决的是不同层面的重复计算,但逻辑是一样的:算过的不重算,变化的才算。
Prompt Cache:跨请求复用,省钱省延迟
如果每次请求都带着一段很长的、固定不变的前缀(比如系统提示词、产品文档、工具说明),服务端可以把这段前缀的"处理结果"缓存起来,下次直接复用,不用重新算。
| 可复用的前缀 | 本次新增内容 |
|---|---|
| 系统提示词 → 产品文档 → 工具说明 | 本轮问题 |
缓存命中时,服务端可以复用固定前缀的已有处理结果,再处理新增内容。token 数没变,但有机会减少计算、延迟和费用。
前提: 固定前缀必须在每次请求里保持一致、放在最前面,缓存才能命中。随意重排内容或在前缀里插入动态内容,会让缓存失效。
命中条件可以记成四条:
- 内容完全一致
- 固定前缀放最前面
- 满足目标模型的最低缓存长度等条件
- 缓存仍在有效期内,并满足服务端的复用规则
KV Cache:缓存 K/V,减少生成时的重复计算
大模型生成回答是一个 token 一个 token 往后预测的。Transformer 每层都会对每个 token 算一个"Key"和"Value"向量,这是注意力机制的核心计算。
前端类比: 就像函数的 memoize——同一个入参算过的结果存下来,再遇到不用重新算。模型生成第 n+1 个 token 时,前 n 个 token 的 K/V 向量已经缓存好了,直接复用。
历史 token → 缓存 K/V → 预测第 n+1 个 → 追加 K/V → 继续生成…
代价: 上下文越长、生成越长,KV Cache 占用的 GPU 显存越大。这也是为什么超长上下文模型对部署硬件要求更高。
两者的完整对比
| 比较项 | Prompt Cache | KV Cache |
|---|---|---|
| 作用范围 | 跨多次请求复用前缀 | 生成过程中的 K/V 状态复用,也可作为前缀缓存的底层状态 |
| 由谁管理 | 服务端(你可配置前缀结构) | 推理引擎自动,无需配置 |
| 对账单的影响 | ✅ 有,命中后输入 token 打折 | ❌ 无直接影响 |
| 对延迟的影响 | 降低 TTFT(首 token 延迟) | 加速每步解码速度 |
| 使用者能感知吗 | ✅ 能,看 cached_tokens |
❌ 无感知,推理引擎内部自动处理 |
| 会改变 token 切法吗 | ❌ 不改变 | ❌ 不改变 |
Prompt Cache 怎么开启
OpenAI
以本文示例使用的 GPT-4o 为例,重复前缀由服务端自动缓存。其他模型的最低长度、保留时间和控制参数可能不同,接入时应查对应模型的 Prompt Caching 官方文档。使用 Chat Completions 时,可以从 usage.prompt_tokens_details.cached_tokens 查看缓存 token 数。
Anthropic Claude
Claude 支持通过 cache_control 开启自动缓存,也可以在内容块上显式标记断点。下面保留显式断点的写法。缓存读取和写入分别计费,命中折扣、最低长度和有效期以目标模型的 Prompt Caching 官方文档为准。
// Claude Prompt Cache 示例
{
  "role": "user",
  "content": [
    {
      "type": "text",
      "text": "你是一个专业助手...(长系统提示词)",
      "cache_control": { "type": "ephemeral" }
    },
    {
      "type": "text",
      "text": "今天的问题是:..."
    }
  ]
}
Prompt Cache
跨请求复用相同前缀。对使用者有感知:账单变便宜,TTFT 降低。
KV Cache
单次生成内部的优化。对使用者无感知,推理引擎自动处理。
两者共同点
都不会改变同一输入的 token 切分和数量。Token 序列决定可复用的前缀,缓存策略决定如何复用已有的计算结果。
最后一句:
Token 是模型处理文本、计量上下文和构建缓存的基本单位。统计 token 要用目标模型的 tokenizer;固定长前缀放最前面让 Prompt Cache 命中;别用字符数估算成本。